

Ei! Como fornecedor de transformadores compactos, eu estive no joelho - no fundo do mundo desses dispositivos bacanas. Um dos aspectos mais cruciais que podem fazer ou interromper o desempenho dos transformadores compactos é o processamento de dados. Então, vamos mergulhar no que eu acho que é a melhor maneira de pré -processar dados para esses transformadores.
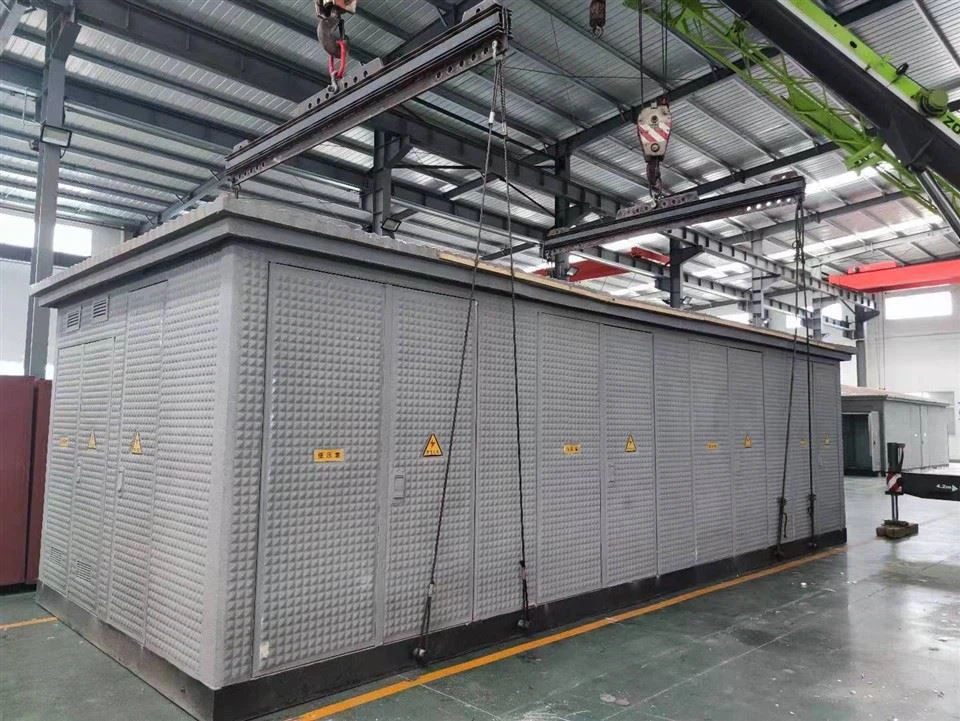
Primeiro, por que os dados pré -processam é tão importante para transformadores compactos? Bem, transformadores compactos são usados em uma ampla gama de aplicações, deTransformador de subestação compactaem grades elétricos paraNovo Energy Integrated Integrated Photovoltaic Pré -fabricado Cabin MV e HV Transformers Cutting - Equipamento de distribuição de borda. Os dados que eles lidam podem ser confusos, barulhentos e inconsistentes. Se não processarmos os dados corretamente, eles poderão levar a previsões imprecisas, desempenho ruim e até falhas do sistema.
Limpando os dados
A primeira etapa no pré -processamento de dados é a limpeza. É como arrumar uma sala bagunçada antes que você possa começar a usá -lo de maneira eficaz. No contexto de transformadores compactos, os dados que coletamos podem ter valores ausentes, outliers ou entradas incorretas.
Os valores ausentes são um problema comum. Eles podem ocorrer devido a mau funcionamento do sensor, erros de comunicação ou simplesmente erro humano. Uma maneira de lidar com valores ausentes é simplesmente remover as linhas ou colunas com dados ausentes. Mas isso pode ser um pouco extremo, especialmente se estamos lidando com dados limitados. Uma abordagem melhor é imputar os valores ausentes. Podemos usar métodos como imputação média, onde substituímos o valor ausente pela média dos valores não ausentes nessa coluna. Por exemplo, se estamos analisando os dados de temperatura de um transformador compacto e há uma leitura de temperatura ausente, podemos calcular a temperatura média de todas as outras leituras e usá -las como substituto.
Os valores extremos são outra dor de cabeça. Estes são pontos de dados que são significativamente diferentes do restante dos dados. Eles podem ser causados por falhas de sensores ou condições operacionais anormais. Podemos identificar outliers usando métodos estatísticos como o intervalo interquartil (IQR). Depois de identificá -los, podemos removê -los ou transformá -los. Por exemplo, podemos usar uma transformação de log para reduzir o impacto de valores extremos.
Normalização
Após a limpeza dos dados, a próxima etapa é a normalização. Isso é importante porque diferentes recursos em nossos dados podem ter escalas diferentes. Por exemplo, os dados de tensão de um transformador compacto podem variar de alguns volts a milhares de volts, enquanto os dados atuais podem estar na faixa de miliamperes a amperes. Se não normalizarmos os dados, os recursos com escalas maiores podem dominar a análise e os recursos com escalas menores podem ser negligenciados.
Existem vários métodos de normalização que podemos usar. Um dos mais populares é o min - normalização máxima. Este método escala os dados para que todos os valores estejam entre 0 e 1. A fórmula para a normalização min - máxima é (x_ {norma} = \ frac {x - x_ {min}} {x_ {max} -x_ {min}}), onde o valor de Data é o valor original, (X_} valor máximo. Outro método é z - normalização da pontuação, que padroniza os dados para que ele tenha uma média de 0 e um desvio padrão de 1. A fórmula para a normalização da pontuação z é (z = \ frac {x- \ mu} {\ sigma}), onde (x) é o valor original (\ mu) é o meio do conjunto de dados e (\ sigr (x) é o valor original (\ mu) é o meio do conjunto de dados e (\ sigr.
Seleção de recursos
A seleção de recursos é uma questão de escolher os recursos mais relevantes para nossa análise. No caso de transformadores compactos, podemos coletar muitos dados de vários sensores, mas nem tudo isso pode ser útil. Por exemplo, podemos estar coletando dados sobre a cor do invólucro do transformador, mas isso provavelmente não terá nenhum impacto no seu desempenho.
Existem dois tipos principais de métodos de seleção de recursos: métodos de filtro e métodos de wrapper. Os métodos de filtro usam medidas estatísticas para classificar os recursos com base em sua relevância. Por exemplo, podemos usar a análise de correlação para ver quais recursos estão fortemente correlacionados com a saída em que estamos interessados, como a eficiência do transformador compacto. Os métodos de wrapper, por outro lado, usam um algoritmo de aprendizado de máquina para avaliar diferentes subconjuntos de recursos. Eles começam com um conjunto inicial de recursos e, em seguida, adicionam ou removem os recursos com base no desempenho do modelo.

Codificação de dados categóricos
Além dos dados numéricos, também podemos ter dados categóricos ao lidar com transformadores compactos. Por exemplo, o tipo de isolamento usado em um transformador pode ser uma variável categórica, com valores como "óleo - preenchido", "tipo seco", etc. Os algoritmos de aprendizado de máquina geralmente não podem lidar diretamente com os dados categóricos, por isso precisamos codificá -lo.
Um método de codificação comum é uma codificação a quente. Isso cria uma nova coluna binária para cada categoria. Por exemplo, se tivermos três tipos de isolamento: petróleo - preenchido, tipo seco e gases - uma codificação a quente criará três novas colunas. Se um transformador tiver isolamento preenchido por óleo, a coluna cheia de óleo terá um valor de 1 e as outras duas colunas terão um valor de 0.
Aumentação de dados
O aumento de dados é uma ótima maneira de aumentar o tamanho e a diversidade do nosso conjunto de dados. No contexto de transformadores compactos, podemos usar técnicas como rotação, escala e adição de ruído. Por exemplo, podemos adicionar uma pequena quantidade de ruído aleatório à tensão e dados atuais para simular variações reais - mundiais. Isso pode ajudar nossos modelos a se tornarem mais robustos e mais capazes de generalizar para novos dados.
Por que tudo importa
Todas essas etapas de pré -processamento são cruciais para tirar o máximo proveito de nossos transformadores compactos. Ao limpar os dados, garantimos que nossa análise seja baseada em informações precisas. A normalização ajuda nossos modelos a convergir mais rapidamente e ter um desempenho melhor. A seleção de recursos reduz a complexidade de nossos modelos e melhora sua interpretabilidade. A codificação de dados categóricos nos permite usar todas as informações disponíveis, e o aumento de dados torna nossos modelos mais resilientes.
Se você está no mercado paraTransformadores compactos, você deve garantir que o pré -processamento dos dados seja feito corretamente. Um conjunto de dados bem processado pode levar a melhores transformadores, o que significa custos mais baixos, maior eficiência e menos tempo de inatividade.
Vamos conversar
Se você estiver interessado em aprender mais sobre nossos transformadores compactos ou tiver alguma dúvida sobre o pré -processamento de dados, eu adoraria ouvir você. Seja você um engenheiro que procura a melhor solução para o seu projeto ou um profissional de compras responsável por fornecer transformadores de alta qualidade, estamos aqui para ajudar. Entre em contato conosco e vamos iniciar uma conversa sobre como podemos atender às suas necessidades.
Referências
- Han, J., Kamber, M., & Pei, J. (2011). Mineração de dados: conceitos e técnicas. Morgan Kaufmann.
- Bishop, CM (2006). Reconhecimento de padrões e aprendizado de máquina. Springer.